+49 2234 2196 750
 it-beratung@serverhero.de


Vom Ausfallrisiko zur Hochverfügbarkeit: IT-Infrastruktur für einen internationalen Marktführer
Ausgangslage:
Globaler Marktführer mit lokaler IT-Hypothek
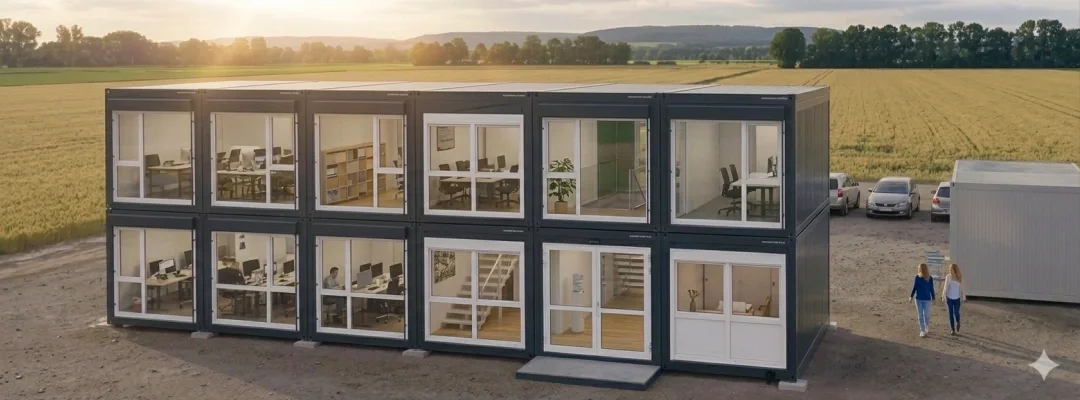
Ein Unternehmen mit zahlreichen Standorten weltweit, einer Vielzahl an Containern im Bestand und einer großen Anzahl an Mitarbeitenden hat sich über viele Jahre hinweg als Spezialist für modulare Raumsysteme etabliert. Das familiengeführte Unternehmen beliefert Kunden aus Bau, Industrie und öffentlichem Sektor – Branchen, in denen Termintreue und Verfügbarkeit entscheidend sind. Was im Kerngeschäft selbstverständlich ist, fehlte jedoch dort, wo es am wenigsten erwartet wurde: in der eigenen IT-Infrastruktur. Die Virtualisierungsumgebung, auf der sämtliche geschäftskritischen Anwendungen liefen, war in die Jahre gekommen. Performance-Engpässe bremsten Prozesse. Und das größte Risiko war unsichtbar: Es gab keine echte Ausfallsicherheit.
Die Herausforderung:
Wenn Ausfallsicherheit zur Achillesferse wird
Die IT-Abteilung stand vor einem Problem, das sich nicht mit Patch-Management lösen ließ. Die bestehende Server-Landschaft war zwar funktional, aber sie operierte am Limit. Jede neue VM-Umgebung, jeder zusätzliche Workload verzögerte sich, weil schlichtweg die Rechenleistung fehlte. Die Storage-Systeme kamen nicht hinterher. Doch das eigentliche Risiko lag tiefer: Es gab keinen Storage-Cluster, keine Redundanz über Brandabschnitte hinweg. Im Klartext bedeutete das: Ein Ausfall hätte weitreichende Konsequenzen für den laufenden Betrieb gehabt. Wartungsfenster wurden zur nervlichen Belastung, weil jede Downtime ein Geschäftsrisiko darstellte. Für ein Unternehmen, das seinen Kunden Flexibilität und Verfügbarkeit verspricht, war diese Situation unhaltbar. Die Entscheidung fiel: Die gesamte Virtualisierungsinfrastruktur musste erneuert werden – nicht als punktuelle Aufrüstung, sondern als strategischer Neuaufbau in zwei Phasen.
Die Lösungsarchitektur:
Ein Fundament für digitale Resilienz – in zwei Phasen
Das Konzept war von Anfang an klar: eine vollständig redundante Virtualisierungsumgebung mit acht identischen Servern, einem clustergestützten All-Flash-Storage und einer einheitlichen VMware-Plattform. Die Umsetzung sollte in zwei Schritten erfolgen. Phase eins umfasste vier Server, zwei Storage-Systeme, FC-Switches und die VMware-Lizenzierung. Phase zwei würde die Infrastruktur spiegeln – mit vier weiteren Servern, zusätzlichen Flash-Laufwerken für die Storage-Systeme und der finalen VMware-Foundation-Lizenzierung. Das Konzept und Design stammten vollständig von Serverhero. Die Hardwarekomponenten wurden exakt auf die Anforderungen des Kunden abgestimmt: Anzahl der VMs, Workload-Charakteristik, Skalierungsreserven.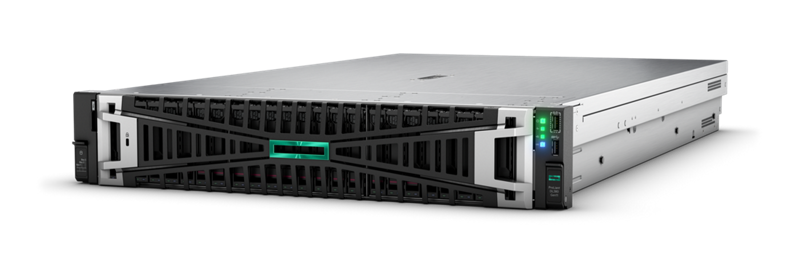
Doch der erste Schritt verlief anders als geplant. Phase eins ging an einen Mitbewerber, der mit einem aggressiveren Preis überzeugt hatte. Was folgte, war eine schmerzhafte Lektion: Der beauftragte Anbieter konnte das Projekt nicht zur Zufriedenheit des Kunden umsetzen. Kritische Probleme bei der Inbetriebnahme der IBM-Storage-Systeme blieben ungelöst. An dieser Stelle trat Serverhero wieder auf den Plan – nicht mit Schadenfreude, sondern mit praktischer Unterstützung. Das Unternehmen vermittelte einen spezialisierten Dienstleister, der die Fibre-Channel-Switches und den IBM-Storage-Cluster konfigurierte und in Betrieb nahm. Der Dienstleister wurde zur dauerhaften Stütze für das Storage-Management des Kunden. Und als Phase zwei ausgeschrieben wurde, fiel die Entscheidung diesmal anders aus: Der Zuschlag ging an Serverhero.
Die technische Lösung für Phase zwei basierte auf zwei zentralen Säulen. Die erste war der HPE ProLiant DL380 Gen11 – ein 2U-Dual-Socket-Server, der auf den Intel Xeon Scalable-Prozessoren der 5. Generation aufbaut. In der konkreten Konfiguration kamen zwei Intel Xeon Gold 6442Y-Prozessoren zum Einsatz: jeweils 24 Kerne, 2,6 GHz Basistakt, zusammen 48 Threads. Jeder Server war mit 512 GB DDR5-4800-Speicher ausgestattet – verteilt auf 16 DIMMs pro CPU-Socket. Die höhere Speicherbandbreite von DDR5 gegenüber DDR4 und die Unterstützung von bis zu 8 TB RAM pro System ermöglichen es, speicherintensive Virtualisierungs-Workloads zu konsolidieren. Der PCIe-Gen5-Bus mit bis zu 80 Lanes pro Server schafft die Grundlage für Hochgeschwindigkeits-I/O: Fibre-Channel-HBAs, 10-GbE-Netzwerkadapter und NVMe-Boot-Controller teilen sich eine Bandbreite, die bisherige Generationen nicht bieten konnten. Jeder Server verfügt über redundante Hot-Plug-Netzteile und Hot-Plug-Lüfter – Standardvoraussetzungen für einen ausfallsicheren Betrieb.
Die zweite Säule war das IBM All-Flash-Storage-Cluster, angebunden über Fibre Channel. Zwanzig 3,84-TB-SAS-Flash-Laufwerke mit 12 Gb/s wurden in die bestehenden beiden IBM-Storage-Systeme integriert und im Cluster-Modus betrieben. Die duale Controller-Architektur der IBM-Systeme, kombiniert mit redundanten Fibre-Channel-Pfaden, eliminiert Single Points of Failure auf der Storage-Ebene. 12 Gb SAS bietet doppelt so viel Bandbreite wie ältere 6-Gb-Interfaces – ein entscheidender Vorteil für IOPS-intensive Virtualisierungs-Umgebungen. Die Cluster-Funktionalität ermöglicht es, die Last zwischen den Storage-Knoten zu verteilen und gleichzeitig Failover-Mechanismen zu nutzen, falls ein Controller ausfällt. Die Verbindung zwischen den HPE-Servern und dem IBM-Storage erfolgte über HPE SN1610E Fibre-Channel-HBAs mit 32 Gb/s – genug Durchsatz, um auch zukünftige Workloads ohne I/O-Bottlenecks zu bedienen.
Die dritte Komponente war die VMware vSphere Foundation-Lizenzierung für fünf Jahre. Der Kunde wollte unbedingt im VMware-Ökosystem bleiben, stand jedoch vor der Herausforderung, dass seine bisherige Enterprise-Plus-Edition nicht mehr zum neuen Portfolio-Modell von Broadcom passte. vSphere Foundation enthält die vollständige Enterprise-Plus-Funktionalität – inklusive vSphere HA, DRS, vMotion, Distributed Switch – plus zusätzliche Management- und Monitoring-Funktionen. Entscheidend war: Die Foundation-Lizenz ermöglicht es dem Kunden, auf kommende Hauptversionen von vSphere zu migrieren, ohne in Lizenzunsicherheit zu geraten. In Kombination mit den fünfjährigen Garantielaufzeiten für Server und Storage schafft das eine verlässliche Planungsgrundlage für die IT-Strategie der kommenden Jahre.
Serverheros Rolle ging weit über die reine Hardwarebeschaffung hinaus. Das Sizing der Server und Storage-Systeme erfolgte in enger Abstimmung mit dem Kunden – basierend auf der geplanten Anzahl virtueller Maschinen, der Workload-Charakteristik und den Wachstumsprognosen. Als in Phase eins der Mitbewerber scheiterte, vermittelte Serverhero den Spezialisten, der die IBM-Systeme erfolgreich in Betrieb nahm. Diese Unterstützung war kein Verkaufsargument, sondern ein Beweis für partnerschaftliches Handeln – und sie zahlte sich aus, als Phase zwei anstand.
Potenzieller Business Value:
Betriebssicherheit als neuer Standard
Die neue Infrastruktur schafft ein Fundament, das weit über technische Spezifikationen hinausgeht. Für das IT-Team bedeutet sie eine fundamentale Veränderung im täglichen Betrieb. Wartungsfenster sind heute kein Stresstest mehr. Dank der Redundanz über acht identische Server und den Storage-Cluster können Updates, Patches und Wartungsarbeiten im laufenden Betrieb durchgeführt werden. VMs lassen sich per vMotion zwischen den Hosts verschieben, ohne dass Anwender etwas davon bemerken. Der administrative Aufwand sinkt, weil die Standardisierung auf ein einziges Server-Modell das Management vereinfacht. Die identische Konfiguration aller acht HPE-DL380-Gen11-Systeme bedeutet: einheitliche BIOS-Versionen, einheitliche Firmware, einheitliche Treiber. Probleme lassen sich schneller diagnostizieren, weil es keine Abweichungen zwischen den Systemen gibt.
Aus geschäftlicher Sicht ist die wichtigste Errungenschaft die Ausfallsicherheit über zwei Brandabschnitte hinweg. Die Infrastruktur ist heute so ausgelegt, dass ein kompletter Ausfall eines Brandabschnitts – sei es durch technisches Versagen, Wartungsarbeiten oder äußere Einflüsse – keine Unterbrechung der geschäftskritischen Anwendungen zur Folge hat. Die VMware-HA-Funktionalität sorgt dafür, dass VMs automatisch auf die verbleibenden Hosts verschoben werden. Der Storage-Cluster stellt sicher, dass die Daten auf beiden Systemen verfügbar bleiben. Diese Architektur ist kein Luxus, sondern eine Notwendigkeit für ein Unternehmen, das internationale Lieferketten und zeitkritische Kundenprojekte managt.
Die Skalierbarkeit der Lösung ist ein weiterer strategischer Vorteil. Sollte die Anzahl der VMs steigen oder neue, rechenintensive Workloads hinzukommen, kann der Kunde einfach weitere HPE ProLiant DL380 Gen11 Server hinzufügen – ohne Architekturbruch, ohne neue Switche, ohne Neukonfiguration der Storage-Anbindung. Die vorhandenen Fibre-Channel-Switches bieten noch freie Ports. Die IBM-Storage-Systeme lassen sich bei Bedarf mit zusätzlichen Flash-Laufwerken erweitern. Und die VMware-Foundation-Lizenz für fünf Jahre gibt die Gewissheit, dass auch zukünftige Software-Releases abgedeckt sind. Diese Planungssicherheit ist in einer Zeit, in der Lizenzmodelle sich rapide verändern, alles andere als selbstverständlich.
Die TCO-Betrachtung hat sich ebenfalls verschoben. Zwar war die initiale Investition höher als beim gescheiterten Wettbewerber in Phase eins – doch die Gesamtkosten über fünf Jahre sind kalkulierbar. Keine unerwarteten Lizenzkosten. Keine Notfall-Hardware-Beschaffung wegen unerwarteter Ausfälle. Keine Kosten für externe Notfall-Dienstleister, weil die Systeme nicht laufen. Stattdessen: ein redundanter, hochverfügbarer Stack, der für die nächsten Jahre stabil läuft und dem IT-Team die Freiheit gibt, sich auf strategische Projekte zu konzentrieren statt auf permanentes Troubleshooting.

Die bestehende Infrastruktur war funktional, aber sie hatte keine Reserven mehr – weder in der Performance noch in der Ausfallsicherheit. Für ein Unternehmen dieser Größe ist das auf Dauer kein tragbarer Zustand.
Fazit:
Wenn Partnerschaft den Preis schlägt
Die Geschichte dieses Projekts ist die Geschichte einer Erkenntnis: Der niedrigste Preis ist nicht immer die wirtschaftlichste Entscheidung. Phase eins ging verloren – aber Phase zwei wurde gewonnen, weil Serverhero in der kritischen Situation nicht wegschaute, sondern half. Das Sizing, das Design, die Vermittlung des Storage-Spezialisten und die reibungslose Umsetzung von Phase zwei haben bewiesen, dass technische Kompetenz und verlässliche Partnerschaft langfristig mehr wert sind als ein kurzfristiger Preisvorteil. Der Kunde hat heute eine Infrastruktur, die läuft. Und eine Partnerschaft, auf die er bauen kann.
Lösungen im Detail
Hardware
-
4× HPE ProLiant DL380 Gen11 Server
-
8× Intel Xeon Gold 6442Y
-
20× IBM 3,84TB 12 Gb SAS Flash Drives
Software
-
VMware vSphere Foundation
-
HPE iLO Advanced License
- HPE GreenLake for Compute Ops Management
Sie haben ein Projekt, das Sie voranbringen möchten?
Erzählen Sie uns kurz von Ihrer Idee – wir prüfen, wie wir Sie optimal unterstützen können. Füllen Sie unser Formular aus oder wenden Sie sich direkt an unseren Vertrieb – wir melden uns umgehend bei Ihnen.